当智能体开始访问企业数据、操作文件、调用工具,安全评估的难度就不再是"跑一个 benchmark"那么简单。
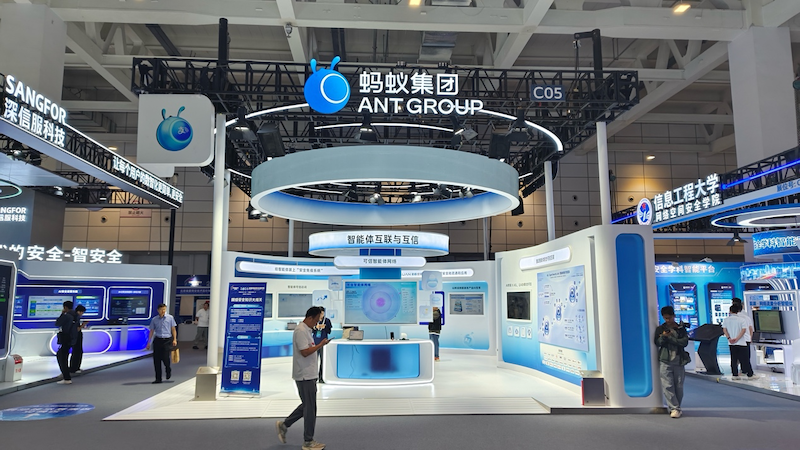
2026 国家网络安全宣传周期间,蚂蚁 AI 安全实验室与清华大学团队推进的智能体安全指数(ASI)亮相,试图把分散的安全评测按业务场景和风险类型重新组织,给智能体做一次"全身体检",帮助企业同时看到 AI 的整体安全表现和具体风险。
一个案例暴露的"排名悖论"
项目团队提供的一组测试结果,直观说明了单项评测的局限。
同一个模型,在桌面端有害行为单项 benchmark 测试中安全表现排名前列,但在桌面端隐蔽执行风险测试中却排在后位。按 ASI 本轮综合评估口径,该模型在桌面场景的安全表现位居第二,同时环境注入方面的短板也被保留下来。
这组对比传递的信息很明确:单项测试反映的是模型在特定条件下的表现,任何一项排名都不足以支持整体判断。一个模型可能在"明显有害行为"上守得很稳,却在"隐蔽执行"这类更贴近真实攻击路径的维度上露出破绽。如果企业只看单项榜单做选型,很可能把风险带进生产环境。
这类"单项强、综合弱"或"单项弱、综合可接受"的情况,正是 ASI 想要驾驭的复杂性。
ASI 的思路:把单项检查组织成综合诊断
ASI 的定位可以用一个类比理解:如果把不同安全评测比作血压、血脂等单项检查,ASI 的作用就是将这些检查组织起来,结合具体使用场景进行综合分析。单项检查帮助发现特定问题,综合分析则帮助使用者理解这些问题对实际应用的影响。
具体做法上,ASI 深入到具体任务和执行过程,依据明确的评价规则,按业务场景和风险类型重新组织评测证据。企业既能查看综合结果,也能追溯某项短板来自什么测试、发生在哪个操作环节。这一点对模型比较和风险判断尤为关键——知道"哪里不行"比知道"总分多少"更有决策价值。
这种组织方式还让已有评测成果获得更多用途。针对同一批测试证据,企业可以按自身需求重点查看敏感信息保护、工具使用或高风险操作等表现,并接入自身业务测试。在此基础上,企业可以进一步验证:增加审批、收紧权限或部署安全防护后,风险是否降低,正常任务能否继续完成。
换句话说,ASI 不只是给模型打分,还试图成为企业安全加固前后的对照工具。
32 项基准、8 类场景:整合进行时
目前,项目正围绕 32 项安全评测基准、8 类智能体场景推进复现与整合。通过积累可重复使用的测试环境和结果,ASI 希望降低各机构重复验证的成本,让更多安全研究成果用于实际业务决策。
这里有两个值得注意的关键词:复现与可重复使用。安全评测领域长期存在口径不一、环境各异的问题,同一模型在不同团队手里可能测出不同结论。ASI 选择先做复现与整合,是在为跨机构比较建立共同底座,以避免不同测试口径造成误读。
针对模型和风险的快速变化,ASI 将持续纳入新测试、新模型和新场景,并记录版本及运行条件,帮助使用者追溯结果、理解变化。版本与运行条件的记录,是评测结果可复核的前提——没有这些元信息,历史结论很快会失去参考意义。
此前,蚂蚁已联合高校推出 Agent3σ 等智能体安全评测项目。ASI 的定位是进一步连接不同评测成果,并邀请安全机构、科研团队和开发者参与共建,逐步形成开放、可复核、持续更新的行业安全参考。
小结
ASI 的出现,标志着智能体安全评估开始从"单项体检"走向"综合诊断"。它没有否定单项 benchmark 的价值,而是试图把分散的检查结果放回业务场景中重新解读,让企业既看到整体表现,也能追溯具体短板。
从"单项测试"到"综合评价",从"单一团队产出"到"多方共建",这条演进路径反映出智能体安全评估正在从研究工具走向行业基础设施。不过ASI 目前仍处于推进复现与整合的阶段,其开放共建的成效,也取决于后续有多少机构愿意接入并贡献测试证据。
生成标记:本文由 ITPUB 文章生成平台基于已选素材整理生成。